Zarządzanie IoT7 min czytania
Co jest najdroższą częścią Twojego produktu?
Ile naprawdę kosztuje Cię wizyta serwisowa, ile kosztuje rezygnacja z wysyłania serwisanta i jak sprawdzić, który z tych kosztów jest większy w Twojej flocie.
Poza samą inwestycją - zakupem, wynajmem albo zbudowaniem produktu - jest etap, który zwykle się zaniedbuje. Niektóre firmy wiedzą dokładnie, ile kosztuje, inne wiedzą to pośrednio: jako koszt rozproszony między wynagrodzenia, ubezpieczenia i paliwo. Etap, o którym opowiemy w tym wpisie, to utrzymanie. Serwis, wyjazd technika (truck roll) - nazywaj to, jak chcesz. Omówimy wszystko: od definicji, przez pomiar, po działania naprawcze. Niezależnie od tego, w jakim miejscu jesteś, znajdziesz tu coś przydatnego. Przejdźmy od razu do rzeczy.
Ile naprawdę kosztuje wizyta
Znasz ten scenariusz: coś przestało działać, dzwoni klient, wysyłasz kogoś, żeby rozwiązał problem. To jest koszt. Paliwo i stawka godzinowa to zwykle jedyne pozycje, o których wszyscy pamiętają. Rzeczywistość jest bardziej złożona, więc od razu do konkretów:
- Dzień pracy technika - cały dzień, a nie godzina spędzona przy usterce.
- Pojazd - koszt za kilometr/milę, ubezpieczenie, wynajem.
- Praca, która wypadła z grafiku - technik miał zrobić instalację u nowego klienta? Trudno, stary klient ma problem.
- Druga wizyta - zwykle co piąty wyjazd trzeba powtórzyć.
- Koordynacja - przyjęcie zgłoszenia, planowanie, raport, fakturowanie.
Zapiszmy to w formie wzoru:
V = (D + K + C + O) × (1 + r)
- D - pełny dzienny koszt technika ze wszystkimi narzutami, a nie jego stawka godzinowa
- K - średnia długość wyjazdu w obie strony w kilometrach razy Twoja pełna stawka za kilometr
- C - koordynacja: przyjęcie zgłoszenia, planowanie, raport, fakturowanie
- O - utracony dzień: ile ten technik zarobiłby w tym czasie przy innej pracy
- r - odsetek wyjazdów, które kończą się drugim wyjazdem
Dzień technika za 400, dojazd w obie strony za 110, koordynacja za 60, utracony dzień za 600 i jeden powtórny wyjazd na pięć:
V = (400 + 110 + 60 + 600) × 1,2 ≈ 1 400 za usuniętą usterkę
Jeden z często cytowanych szacunków branżowych wycenia pojedynczy wyjazd serwisowy na kwotę od około 150 do około 1 000 dolarów. Taki siedmiokrotny rozrzut sam w sobie jest argumentem za tym, żeby policzyć własną liczbę, zamiast pożyczać cudzą, niezależnie od tego, jak ją wyliczono.
Dobra wiadomość: większości tego kosztu da się uniknąć
Stara dobra zasada rozwiązywania problemów każe dzielić i rządzić. Podzielmy więc zeszłoroczne wyjazdy na trzy stosy: potrzebne były ręce (H - jakaś część naprawdę była uszkodzona), potrzebne były oczy (E - ustawienie, restart, diagnoza, którą dało się postawić zza biurka), nie były potrzebne ani ręce, ani oczy (N - wszystko już działało). Drugi i trzeci stos to całe uzasadnienie biznesowe.
Koszty możliwe do uniknięcia = (E + N) × V
Warto prowadzić też czwarty stos: wyjazdy, których na podstawie zapisków w ogóle nie da się sklasyfikować (U) - wskaźnik ślepych wyjazdów (blind rate). To stosunek niesklasyfikowanych wyjazdów do wszystkich wyjazdów. Mówi, w ilu przypadkach nie wiesz, co się stało ani jakie było rozwiązanie. Ten wskaźnik powinniśmy maksymalnie ograniczać.
Wskaźnik ślepych wyjazdów = U / (H + E + N + U)
We flocie liczącej 300 urządzeń, przy 180 wyjazdach podzielonych na 60 / 63 / 21 i 36 niesklasyfikowanych, koszty możliwe do uniknięcia wynoszą 117 600 rocznie - to pieniądze wydane na dojazdy do usterek, które nie wymagały kierowcy - a wskaźnik ślepych wyjazdów to 36/180 = 20%: co piąty wyjazd, o którym nie potrafisz powiedzieć, co się wydarzyło. A właśnie tej informacji ktoś od Ciebie zażąda, gdy klient zakwestionuje roszczenie.
Zła wiadomość: to trudniejsze, niż myślisz
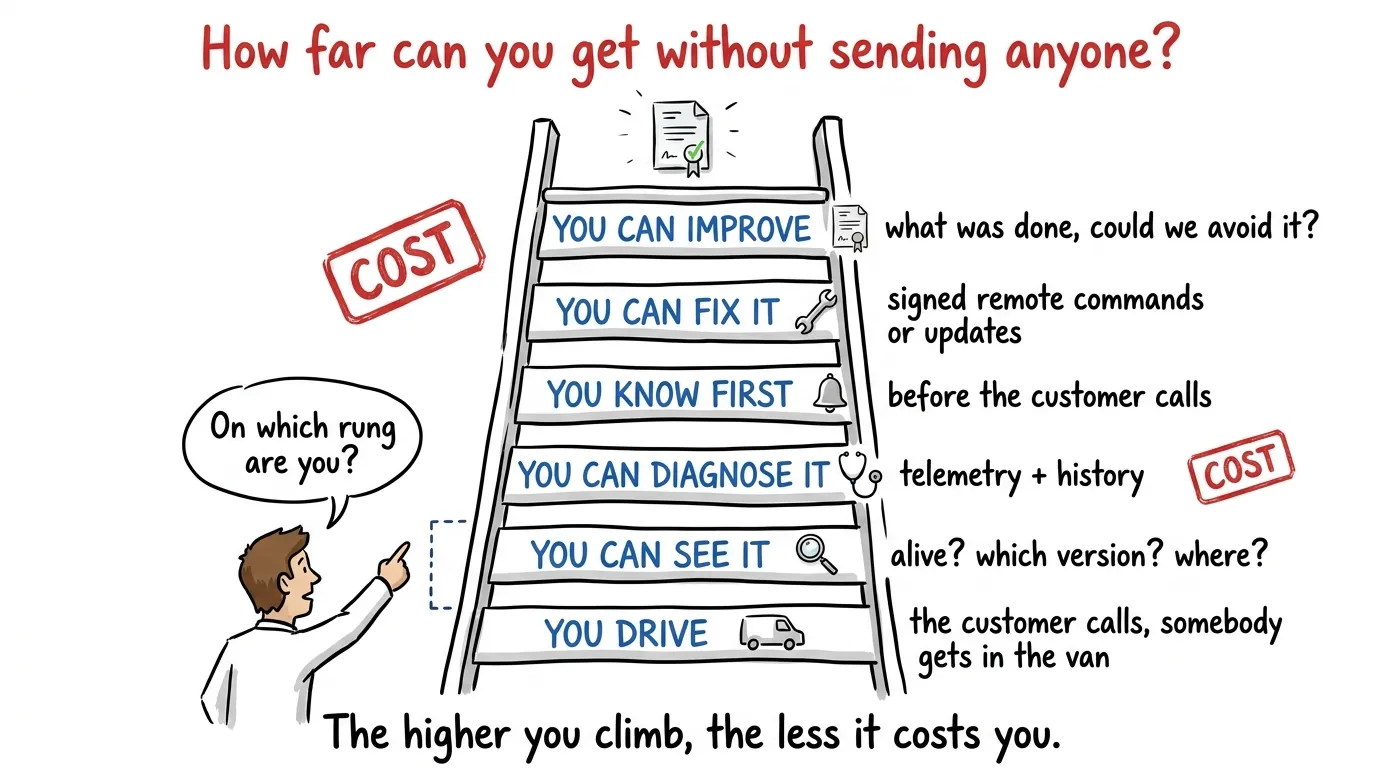
| Szczebel | Co możesz zrobić | Czego to wymaga |
|---|---|---|
| 0 | Nic. Klient dzwoni, Ty jedziesz. | - |
| 1 | Zobacz urządzenie. Czy działa, jaka wersja, jaki stan, gdzie jest. | tożsamość, łączność, inwentarz, który nie jest arkuszem kalkulacyjnym |
| 2 | Zdiagnozuj je bez wizyty. | Zaufaj danym z urządzenia i je analizuj. |
| 3 | Dowiedz się, zanim zrobi to klient. | Niech system obserwuje flotę za Ciebie. Rozszerzenie punktu #2. |
| 4 | Napraw je zdalnie. | Poproś urządzenie o wykonanie działania, wysyłając do niego komendę. Czasem to zwykły restart, czasem zmiana konfiguracji, czasem coś innego. |
| 5 | Możesz się doskonalić. | Dowody: co było na urządzeniu, kto przy nim działał, co zostało zrobione - wszystko po to, żeby odpowiedzieć na jedno pytanie: co możemy zrobić, żeby uniknąć podobnych problemów w przyszłości? |
Każdy szczebel opiera się na tym poniżej: nie zdiagnozujesz urządzenia, którego nie widzisz, ani nie wyślesz poprawki do floty, której nie potrafisz zinwentaryzować.
Wspinaczka nie jest darmowa. Jeśli chcesz zbudować to samodzielnie, oto kilka rzeczy, które musisz wziąć pod uwagę:
- bezpieczeństwo - zarówno danych, jak i operacji - co się stanie, jeśli ktoś przejmie Twoje urządzenie? Albo wyciekną Twoje dane? Albo w bibliotece, z której korzystasz, znajdzie się podatność?
- łączność - co zrobić, gdy urządzenie straci połączenie?
- aktualizacje OTA - jak chcesz poprawiać firmware? Jak wdrożysz zmianę? Jak cofniesz złą zmianę?
- obserwowalność - skąd będziesz wiedzieć, czy Twój serwer działa dobrze? Co, jeśli padnie baza danych?
- skalowalność - jeden serwer wystarczy dla 1 000 urządzeń, ale co, jeśli zarządzasz flotą liczącą 14 000?
- strona urządzenia - tożsamość dla każdego egzemplarza, firmware, który raportuje własny stan, a może nawet potrzebny będzie mały moduł sprzętowy
- zarządzanie pracą - jak będziesz śledzić, kto nad czym pracuje?
Zbudowanie, a potem zarządzanie tym wszystkim przy jednoczesnym prowadzeniu właściwego biznesu to spory ból głowy. Na szczęście istnieje wiele gotowych rozwiązań, które mogą w tym pomóc: od platform open source, takich jak ThingsBoard czy Mender do aktualizacji OTA, przez produkty projektowane z myślą o flotach, takie jak OpenThings (platforma, którą rozwijamy), balena czy Memfault, aż po hyperscalerów z AWS IoT Device Management i Azure IoT Hub.
Wszystko jest kwestią równowagi
Niezależnie od tego, czy zbudujesz to samodzielnie, czy skorzystasz z czegoś gotowego, musisz wiedzieć, kiedy jest właściwy moment. Z naszego doświadczenia wynika, że to moment, w którym jednocześnie spełnione są trzy warunki.
- Argument finansowy jest realny. Koszty możliwe do uniknięcia wyraźnie przewyższają koszt wspinaczki.
- Flota jest wystarczająco duża, żeby to udźwignąć. Jednorazowy koszt inżynierii jest mniej więcej taki sam niezależnie od tego, czy masz czterdzieści urządzeń, czy czterysta, więc rozkłada się na tyle urządzeń, ile masz. W małej flocie proporcja się odwraca: te same miesiące pracy nad firmware zestawiasz ze znacznie mniejszym stosem wyjazdów, których da się uniknąć, i uzasadnienie robi się słabe.
- Znasz własne liczby, a nie średnią branżową. Twoje V, Twój podział na ręce / oczy / nic / niesklasyfikowane, Twoje koszty możliwe do uniknięcia, Twój wskaźnik ślepych wyjazdów - wszystko policzone na podstawie Twoich własnych wyjazdów.
Gdy wszystkie trzy warunki są spełnione, decyzja przestaje być kwestią gustu. Staje się arytmetyką, której obronisz przed każdym, kto ją zatwierdza.
Trzy możliwe drogi
Gdy bilans się zgadza, są trzy sposoby, żeby faktycznie dojść do celu.
Zbuduj to samodzielnie, z własnym zespołem
- Za: pełna kontrola nad modelem i najgłębsze możliwe dopasowanie do własnej roadmapy firmware i sprzętu.
- Przeciw: szukasz ludzi o kompetencjach - bezpieczeństwo embedded, PKI urządzeń, oprogramowanie do zarządzania flotą - które są rzadkie, a ich rekrutacja trwa długo, i każdy kolejny rok utrzymania też spada na Ciebie.
Zatrudnij kogoś, kto zbuduje to dla Ciebie
- Za: szybciej niż budowanie własnego zespołu, a ryzyko dostarczenia pierwszej działającej wersji bierze na siebie ktoś inny.
- Przeciw: wiedza o tym, jak to działa, odchodzi razem z wykonawcą, gdy kończy się umowa, a Ty wracasz do rekrutacji - albo przedłużania umowy - żeby utrzymać system przy życiu.
Skorzystaj z gotowej platformy
- Za: najszybsza droga do działającego pilotażu, ciężar bezpieczeństwa i aktualizacji niesiony przez kogoś, czyją całą pracą jest właśnie ten ciężar, oraz koszt, który widzisz, zanim się zobowiążesz.
- Przeciw: mniej swobody, żeby dopasować platformę do czegoś nietypowego w Twojej flocie, i zależność od cudzej roadmapy - więc zanim podpiszesz umowę, sprawdź, czy w razie potrzeby możesz odejść razem ze swoimi danymi.
Żadna z tych trzech dróg nie jest automatycznie właściwa. To, która pasuje, zależy od tego, jak nietypowa jest Twoja flota, jaką część tego wszystkiego chcesz mieć na własność na zawsze i jak szybko opisany wyżej rachunek ma zamienić się z arytmetyki w coś, co działa.
Podsumowanie
Niezależnie od tego, gdzie teraz jesteś - serwis nie jest jeszcze na Twoim radarze, zaczynasz odczuwać jego koszt, zastanawiasz się, jak to wszystko połączyć, albo masz już coś działającego - skup się na trzech prostych krokach, które pomogą Ci w Twojej sytuacji:
Mierz. Policz swoje V. Oznaczaj każdą wizytę u klienta tym, czego wymagała: ręce / oczy / nic / niesklasyfikowane. Policz, ile urządzeń jest wdrożonych. Regularnie wracaj do tych danych.
Analizuj. Obserwuj trendy, porównuj koszty. Dopiero potem przejdź do następnego kroku.
Decyduj teraz, bo masz liczbę, której ufasz, a nie przeczucie czy intuicję.
Czasem nie warto się wysilać, a czasem to jedyna droga.
Jeśli wolisz nie budować wszystkiego od zera: OpenThings, platforma, którą rozwijamy, powstała, bo raz po raz spotykaliśmy firmy dokładnie w tej sytuacji. Skontaktuj się z nami, jeśli chcesz, żebyśmy pomogli Ci ocenić, na którym szczeblu opisanej wyżej drabiny jest Twoja flota.