Aplikacje5 min czytania
Co GPT Image 2.6 zmienia w aplikacjach firmowych
Jeśli Twoja aplikacja generuje albo edytuje obrazy, albo dopiero planujesz taki krok, przy każdej nowej wersji modelu wracają te same dwa pytania: czy przechodzić na nią i na który model. OpenAI udostępniło GPT Image 2.6 4 listopada 2026 r. w postaci dwóch modeli: Sunburst do pracy wymagającej detalu i precyzyjnej edycji oraz Flare do szybkich iteracji. Tego samego dnia przeczytałem dokumentację, a w zespole zrobiliśmy małe porównanie na dwóch zdjęciach referencyjnych. Krótka odpowiedź: w większości firmowych procesów zacznij od Flare, a na Sunburst postaw tam, gdzie wynik musi dokładnie odpowiadać materiałowi wejściowemu, nawet kosztem dłuższego czekania.
Co faktycznie jest nowe
W przewodniku po generowaniu obrazów wyróżniają się trzy rzeczy:
- Ustawienie
complexity(low,medium,high), które określa, ile model planuje przed renderowaniem. Domyślnie jesthigh, a zmiana poziomu nic nie kosztuje. OpenAI sugeruje niższe wartości przy prostych edycjach, na przykład przy zmianie tła albo napisu na szyldzie, a wyższe przy gęstym tekście i złożonych układach. Ostrzega też, że wyższy poziom może wydłużyć czas odpowiedzi i wprowadzić niechciane zmiany, więc przetestuj poziomy na własnym zadaniu, zanim wybierzesz jeden. - Edycja sterowana znacznikami. Rysujesz kółka albo szkic na przezroczystym PNG i wysyłasz go jako
markuprazem z edycją. Jeśli kiedykolwiek próbowałeś opisać słowami „przesuń logo trochę w lewo”, wiesz, dlaczego to dla mnie najbardziej praktyczna zmiana. Działa też w 2.5. - Wynik w SVG i jako animowany GIF na endpoincie generowania. To ikony i małe animacje bez osobnego kroku konwersji.
Są też ograniczenia, które warto znać, zanim zaczniesz cokolwiek planować. Sunburst i Flare działają tylko przez endpointy generowania i edycji w Image API. Responses API i Batch nie są obsługiwane. Oba modele mają te same stawki: 5 USD za 1M tokenów tekstu na wejściu, 8 USD za 1M tokenów obrazu na wejściu i 30 USD za 1M tokenów obrazu na wyjściu. Oficjalnej ceny za jeden obraz nie ma.
Sunburst i Flare w jednym teście
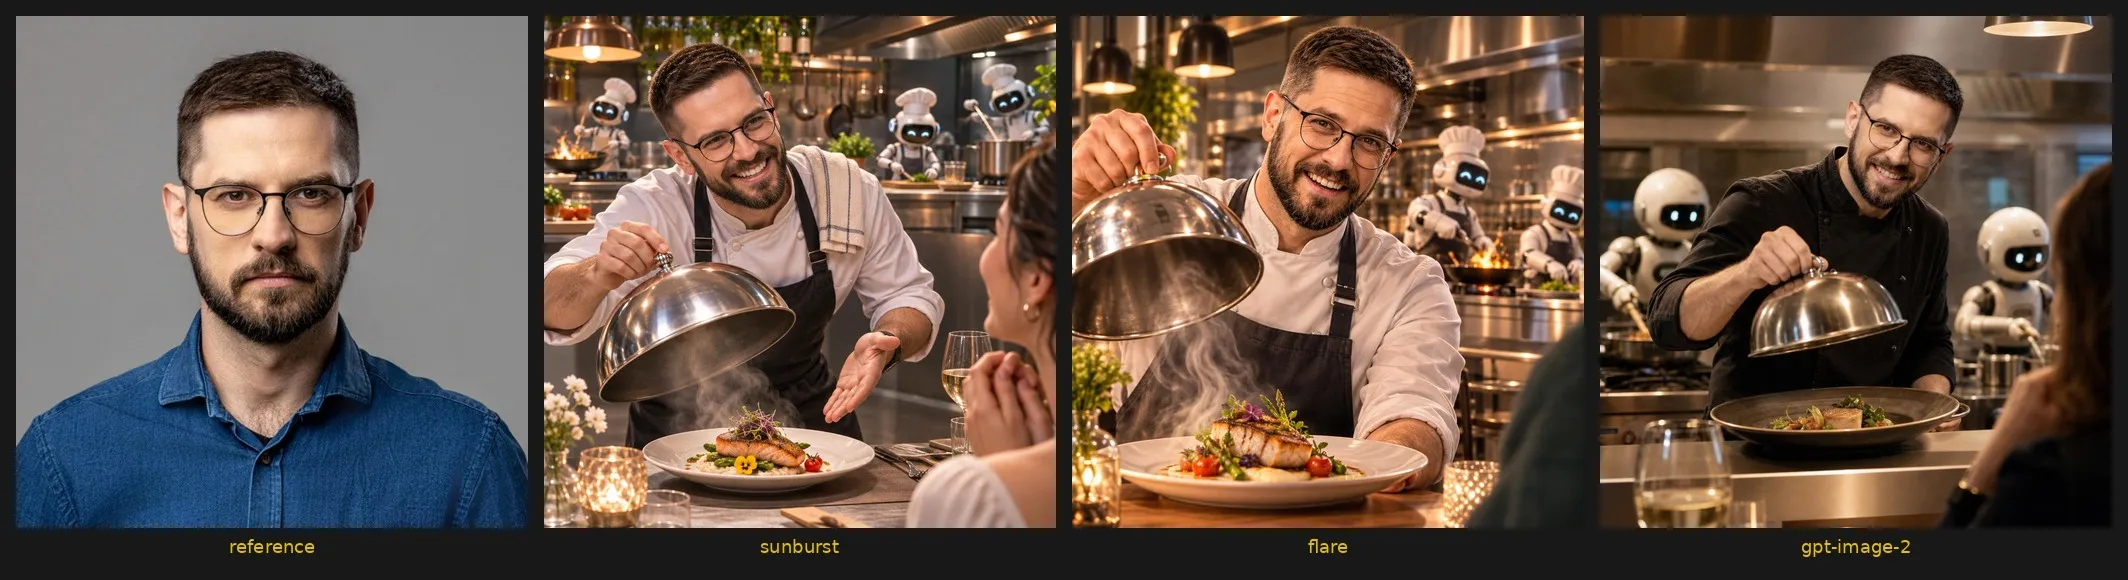
Przepuściliśmy trzy sceny (przewodnik górski, ktoś rozplątujący kłębowisko kabli, szef kuchni podający danie) przez Sunburst, Flare i GPT Image 2. W każdej scenie były dwa zdjęcia referencyjne i ten sam prompt dla każdego modelu, w rozmiarze 1024x1024, z jakością medium i z complexity="medium" tylko dla 2.6, bo GPT Image 2 odrzuca ten parametr. To jeden przebieg na model i scenę, więc traktuj wyniki jako pierwsze rozpoznanie. Do benchmarku potrzeba wielu powtórzeń.
| Model | Czas odpowiedzi, trzy sceny | Koszt z tokenów za obraz |
|---|---|---|
| Sunburst | 22,3-25,3 s | 0,0646-0,0647 USD |
| Flare | 9,6-15,1 s | 0,0646-0,0647 USD |
| GPT Image 2 | 38,8-41,7 s | 0,0737-0,0738 USD (szacunkowo) |
Koszt to zużycie tokenów pomnożone przez opublikowane stawki. Dla GPT Image 2 jest szacunkowy, liczony według tych samych stawek, bo strona modelu nie podaje ceny.
Co z tego wynika:
- Flare był mniej więcej dwa razy szybszy od Sunburst przy dokładnie tym samym koszcie. Sprawdzi się przy okładkach, wariantach i szybkich iteracjach.
- Sunburst najlepiej zachowywał podobieństwo i szczegóły. To model do zdjęć ludzi i precyzyjnych edycji.
- GPT Image 2 był najwolniejszy i około 14% droższy, a do tego nie obsługuje
complexity. Jeśli nie zależy Ci na Batch, nie widzę powodu, żeby przy nim zostawać. - Szkic we Flare, wersja końcowa w Sunburst.
- Nie proś o „identyczną twarz”. W naszych wcześniejszych próbach zamrażało to mimikę. Proś o podobieństwo, nadaj każdej scenie emocję i kąt ujęcia, a do tego dodaj drugie zdjęcie referencyjne.
Dlaczego to ważne w aplikacjach firmowych
Większość funkcji graficznych, które widzę w oprogramowaniu dla firm, dzieli się na dwie grupy. Pierwsza to funkcje interaktywne: podgląd w konfiguratorze produktu, wariant grafiki marketingowej w CMS, szkic ilustracji do dokumentu. Tam różnica między 10-15 a około 40 sekundami zmienia odbiór całej funkcji, a drobne odstępstwa często nie przeszkadzają. Tu pasuje Flare.
Druga grupa to wszystko, co musi pozostać wierne źródłu: zdjęcie produktu do katalogu albo na Allegro, zdjęcie osoby, rysunek techniczny. Każde odstępstwo oznacza, że ktoś musi je wyłapać i poprawić. Tu dopłaciłbym te kilka sekund za Sunburst.
Dwa zastrzeżenia z dokumentacji. Tekst na obrazach nadal jest na liście znanych ograniczeń, więc przy polskich napisach sprawdzaj znaki diakrytyczne, a złożone prompty mogą się przetwarzać nawet 2 minuty. Do tego 2.6 nie obsługuje Batch, więc duże nocne przetwarzanie katalogu może wyjść taniej na 2.5 albo GPT Image 2, gdzie Batch jest dostępny. Strona 2.5 Sunburst podaje dla Batch 15 USD za 1M tokenów obrazu na wyjściu, wobec 30 USD w trybie standardowym.
Co sprawdzić, zanim krok graficzny trafi na produkcję
Samo wywołanie modelu to najprostsza część. Większość pracy w prawdziwej aplikacji dzieje się wokół niego, a przewodnik po generowaniu obrazów odpowiada na kilka ważnych pytań, jeśli doczytasz go dalej niż do przykładów.
Znaczniki mają swoje zasady
Warstwa z adnotacjami musi być osobnym, przezroczystym plikiem PNG o tej samej szerokości i wysokości co pierwszy obraz wejściowy. Nie da się też łączyć markup z mask. Jeśli użytkownicy rysują po obrazie w Twoim interfejsie, eksportuj ich kreski jako osobną warstwę w oryginalnym rozmiarze, zamiast wtapiać je w zdjęcie.
SVG i GIF tylko przy generowaniu
Endpoint edycji nie zwraca żadnego z tych formatów. SVG wymaga ustawienia n na 1 i nie obsługuje streamingu. GIF przyjmuje frame_count (2-64, domyślnie 9) i frame_duration_ms (20-2000, domyślnie 200). Jeśli Twoja funkcja to „popraw tę ikonę”, zaplanuj nowe generowanie z dobrym promptem zamiast edycji.
Spójność między obrazami wciąż jest ograniczeniem
OpenAI przyznaje, że modele mogą mieć problem z utrzymaniem spójnego wyglądu powracających postaci albo elementów marki w kolejnych generacjach. Przy serii grafik z tą samą maskotką albo przy katalogu w jednym stylu wizualnym potrzebujesz człowieka, który zatwierdza każdy obraz przed publikacją.
Przygotuj się na zablokowane zapytania
Część błędów wraca z typem image_generation_user_error, na przykład z kodem moderation_blocked. Dokumentacja zaleca, żeby nie ponawiać takich zapytań automatycznie bez zmiany promptu albo obrazów wejściowych. Pokaż użytkownikowi prosty komunikat, a szczegóły zapisz w logach dla swojego zespołu.
Identyfikuj użytkowników końcowych
Jeśli funkcja obsługuje pojedynczych użytkowników, OpenAI zaleca wysyłanie z każdym zapytaniem stałego safety_identifier, czyli skrótu (hasha) nazwy użytkownika albo adresu e-mail zamiast samego adresu. To jedna linijka kodu.
Zdjęcia wejściowe to też dane
Zdjęcie pracownika czy skan dokumentu klienta to dane osobowe albo poufne, a przy każdym wywołaniu opuszczają Twoją sieć. Zdecyduj, które dane wejściowe w ogóle mogą trafić do zewnętrznego API, tak samo jak przy dokumentach w wyszukiwaniu z prywatnym AI. Przy zdjęciach osób pamiętaj też o RODO.
Od czego bym zaczął
Wybierz jeden krok graficzny w swojej aplikacji, zbierz 10-20 prawdziwych przykładów i przepuść je przez oba modele 2.6. Odpowiedź zawiera obiekt usage, więc koszt zaakceptowanego obrazu możesz liczyć od pierwszego dnia. Licz też obrazy odrzucone: tani obraz, który ktoś musi poprawić, wcale nie jest tani. Przy każdym wywołaniu zapisuj wersję promptu, żeby po każdej zmianie wiedzieć, co właściwie porównujesz. Kod i parametry znajdziesz w poradniku GPT Image 2.6 w aplikacjach firmowych.
Jeśli chcesz omówić, gdzie taki krok pasuje w Twojej aplikacji, możemy przyjrzeć się temu razem.