Case study11 min czytania
NeuroSnake: TinyML i klasyczny Snake na płytce PCB w kształcie węża
Co się stanie, gdy połączysz uwielbianą grę retro, najnowsze uczenie maszynowe i twórczego ducha kultury konferencyjnych identyfikatorów (badge) z DEFCON? Powstaje płytka PCB w kształcie węża, która sama uczy się grać w Snake’a, napędzana sieciami neuronowymi działającymi na mikrokontrolerze z zaledwie 256KB RAM.
Cały projekt zrealizował zespół w składzie: Mikołaj Markiel, Karol Szczepanik, Dzmitry Astrouski, Bart Szczepański.
Od elektronicznej sztuki do półautonomicznej inteligencji
Świat identyfikatorów konferencyjnych przeszedł niezwykłą drogę: od prostych migających diod LED do zaawansowanej, interaktywnej elektroniki, która przesuwa granice przenośnych urządzeń obliczeniowych. Te kieszonkowe cudeńka to wyjątkowe połączenie sztuki, inżynierii i hakerskiej kreatywności.
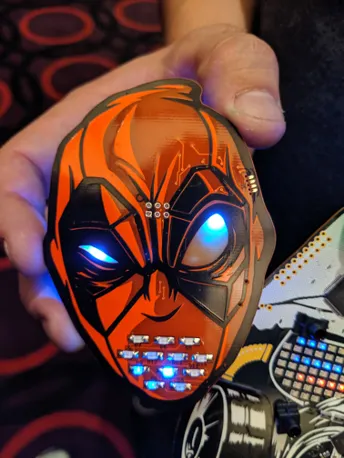
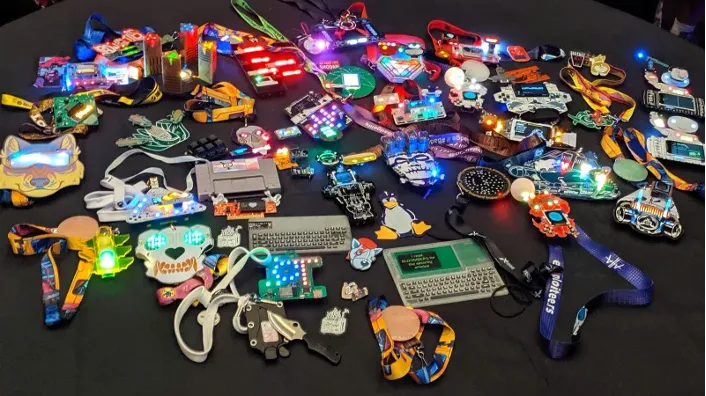
Wystarczy spojrzeć na te projekty: płytki PCB w kształcie czaszek z hipnotyzującymi matrycami LED, misterne grafiki ze wzorów ścieżek i kolekcje obejmujące lata innowacji. Widać wyraźnie, że to coś więcej niż ozdobna elektronika. To wyraz kultury, w której skrajne ograniczenia rodzą najbardziej kreatywne rozwiązania.
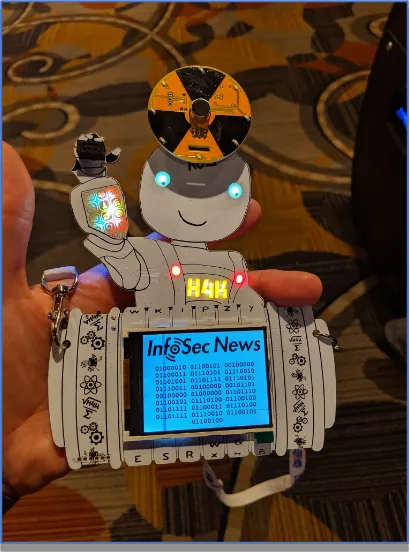
Wyzwanie jest zawsze to samo: jak zmieścić jak najwięcej funkcji w małym urządzeniu na baterię, które naprawdę warto nosić? Rozwiązania sięgały od sieci mesh po gry logiczne, od koparek kryptowalut po pełnoprawne komputery.
Obserwując tę ewolucję, zadaliśmy sobie jednak inne pytanie: A gdyby identyfikator nie tylko reagował na dane wejściowe, ale potrafił się uczyć i dostosowywać? Czy da się zmieścić prawdziwe uczenie maszynowe w czymś na tyle małym, żeby przypiąć to do koszuli?
Odpowiedzią okazał się TinyML, rewolucyjne podejście, które przenosi uczenie maszynowe na najmniejsze urządzenia, jakie można sobie wyobrazić.
Inteligencja na edge, w każdym urządzeniu
TinyML oznacza radykalną zmianę w sztucznej inteligencji. Tradycyjna AI opiera się na potężnych serwerach w chmurze i modelach z miliardami parametrów, a TinyML przenosi inteligencję bezpośrednio do urządzeń, którym wystarczą kilobajty pamięci i miliwaty mocy.
Zamiast wysyłać dane z czujników do chmury, urządzenia podejmują inteligentne decyzje lokalnie, co daje:
- Prywatność od etapu projektowania: Twoje dane nigdy nie opuszczają Twojego urządzenia,
- Bardzo niskie opóźnienia: brak podróży danych przez sieć i natychmiastowe odpowiedzi,
- Efektywność energetyczną: optymalizację pod pracę na baterii,
- Stałą dostępność: działanie bez połączenia z internetem.
W identyfikatorach i elektronice noszonej TinyML otwiera możliwości, które jeszcze kilka lat temu były nie do wyobrażenia. Wyobraź sobie identyfikator, który rozpoznaje Twoje gesty, uczy się Twoich preferencji albo sam gra w gry, a przy tym działa wiele dni na jednym ładowaniu baterii.
NeuroSnake stał się naszą wyprawą na tę granicę. Wzięliśmy powszechnie znaną grę Snake i zapytaliśmy: „Czy da się nauczyć sieć neuronową mistrzowskiej gry, korzystając wyłącznie z zasobów dostępnych na urządzeniu wielkości identyfikatora?”
Ewolucja inteligencji w grach
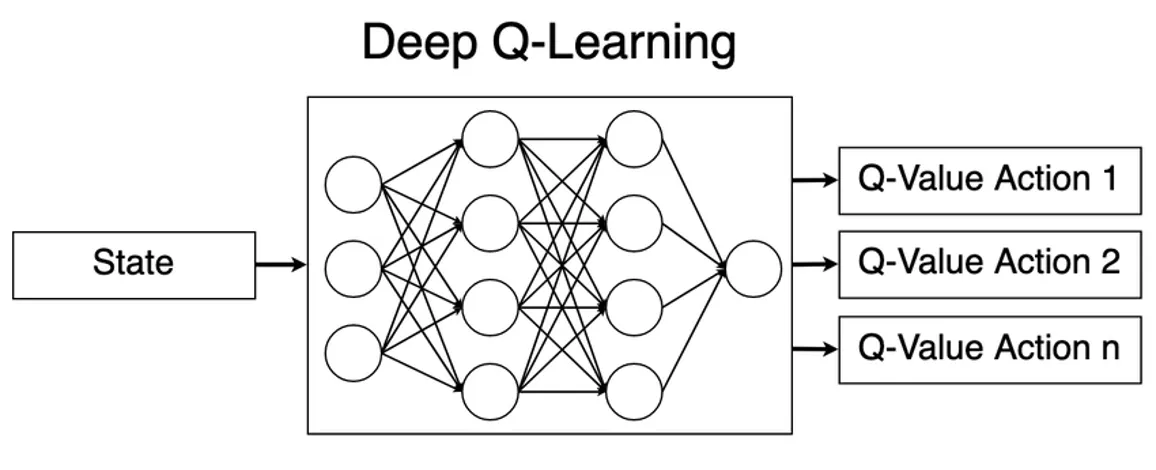
Przejście od prostego uczenia ze wzmocnieniem do agentów opartych na sieciach neuronowych to ważny kamień milowy w dziedzinie sztucznej inteligencji. Żeby zrozumieć, dlaczego NeuroSnake potrzebował uczenia głębokiego, warto zobaczyć, gdzie zawodzą metody tradycyjne.
Klasyczny Q-learning buduje tabelę wartości stan-akcja, idealną dla małych, dyskretnych środowisk. Ale Snake, mimo pozornej prostoty, prowadzi do kombinatorycznej eksplozji możliwych stanów gry. Przy siatce 32x24, wężu o dowolnej długości i jedzeniu, które może pojawić się w dowolnym miejscu, liczba unikalnych stanów szybko staje się astronomiczna.
Deep Q-Networks (DQN) rozwiązują ten problem, zastępując tabelę siecią neuronową, która uczy się rozpoznawać wzorce i przewidywać wartości akcji. Dzięki temu agent radzi sobie z zupełnie nowymi sytuacjami.
Prawdziwa innowacja tkwiła w reprezentacji stanu: zamiast surowych pikseli zaprojektowaliśmy 11-wymiarowy wektor stanu, który oddaje kluczową dynamikę gry:
def _get_state(self):
    """Get current state for the Q-learning agent"""
    head = self.snake_body[0]

    # Calculate adjacent points for collision detection
    point_l = (head[0] - self.block_size, head[1])
    point_r = (head[0] + self.block_size, head[1])
    point_u = (head[0], head[1] - self.block_size)
    point_d = (head[0], head[1] + self.block_size)

    # Current direction (one-hot encoded)
    dir_l = self.direction == 'LEFT'
    dir_r = self.direction == 'RIGHT'
    dir_u = self.direction == 'UP'
    dir_d = self.direction == 'DOWN'

    # Collision detection relative to current direction
    danger_straight = (
        (dir_r and self._is_collision(point_r)) or
        (dir_l and self._is_collision(point_l)) or
        (dir_u and self._is_collision(point_u)) or
        (dir_d and self._is_collision(point_d))
    )

    danger_right = (
        (dir_u and self._is_collision(point_r)) or
        (dir_d and self._is_collision(point_l)) or
        (dir_l and self._is_collision(point_u)) or
        (dir_r and self._is_collision(point_d))
    )

    danger_left = (
        (dir_d and self._is_collision(point_r)) or
        (dir_u and self._is_collision(point_l)) or
        (dir_r and self._is_collision(point_u)) or
        (dir_l and self._is_collision(point_d))
    )

    # Food location relative to head
    food_left = self.food[0] < head[0]
    food_right = self.food[0] > head[0]
    food_up = self.food[1] < head[1]
    food_down = self.food[1] > head[1]

    return np.array([
        danger_straight, danger_right, danger_left,
        dir_l, dir_r, dir_u, dir_d,
        food_left, food_right, food_up, food_down
    ], dtype=int)
Ta zwięzła reprezentacja tworzy 11-wymiarowy wektor stanu:
- 3 flagi zagrożenia kolizją (na wprost, w prawo, w lewo),
- 4 flagi kierunku ruchu (w lewo, w prawo, w górę, w dół),
- 4 flagi kierunku do jedzenia (w lewo, w prawo, w górę, w dół).
Sieć neuronowa uczy się mapować to 11-wymiarowe wejście na optymalne akcje i wypracowuje strategie, które wykraczają daleko poza proste zachowanie oparte na regułach.
Architektura sieci neuronowej została zaprojektowana specjalnie pod to 11-wymiarowe wejście:
def _build_model(self):
    """Neural Network for Deep Q-Learning"""
    model = tf.keras.Sequential([
        # 11-dimensional state input
        tf.keras.Input(shape=(11,)),
        # Hidden layer 1
        tf.keras.layers.Dense(24, activation='relu'),
        # Hidden layer 2
        tf.keras.layers.Dense(24, activation='relu'),
        # 3 actions output (straight, right, left)
        tf.keras.layers.Dense(3, activation='linear')
    ])
    model.compile(loss='mse',
    	optimizer=tf.keras.optimizers.Adam(learning_rate=0.001))
    return model
Ta zwięzła, a zarazem skuteczna architektura przyjmuje 11-wymiarowy wektor stanu i zwraca wartości Q dla trzech możliwych akcji: jedź prosto, skręć w prawo albo skręć w lewo.
Magia dzieje się w potoku konwersji modelu, w którym wytrenowana sieć neuronowa jest przygotowywana do wdrożenia na urządzeniu embedded za pomocą TensorFlow Lite, obecnie przemianowanego na [LiteRT](https://developers.googleblog.com/en/tensorflow-lite-is-now-litert/), żeby nazwa lepiej oddawała jego rolę jako środowiska uruchomieniowego:
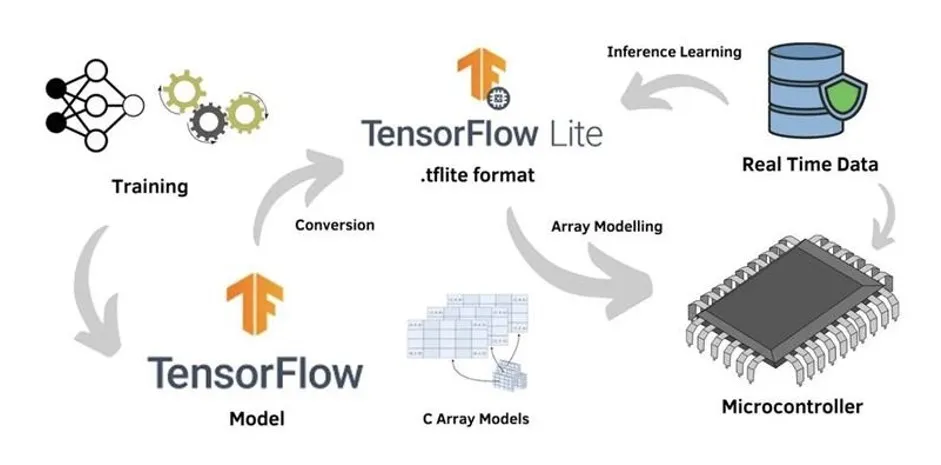
Ten potok jest pomostem między rozwojem AI w skali chmury a wdrożeniem na edge. Bierze naszą sieć neuronową o pełnej precyzji i optymalizuje ją pod surowe ograniczenia sprzętu mikrokontrolerowego.
Python i symulacja: budujemy poligon treningowy
Zanim przenieśliśmy inteligencję na mikrokontroler, musieliśmy zbudować przestrzeń, w której mogła się uczyć i rozwijać. Python z Pygame okazał się idealnym placem zabaw do szybkich eksperymentów.
Środowisko treningowe musiało być na tyle szybkie, żeby obsłużyć tysiące epizodów, a jednocześnie wiernie odwzorowywać mechanikę gry z wersji embedded:
class SnakeGame:
    def __init__(self, width=640, height=480, speed=40):
        self.width = width
        self.height = height
        self.block_size = 20

        # Initialize Pygame environment for training
        pygame.init()
        self.display = pygame.display.set_mode((width, height))
        self.reset()

    def step(self, action):
        """Perform one step: 0=straight, 1=right turn, 2=left turn"""
        self.steps += 1

        # Apply action to change direction
        self._update_direction(action)

        # Move snake head
        new_head = self._calculate_new_head()
        self.snake_body.insert(0, new_head)

        # Check for collision or food
        reward = 0
        game_over = False

        if self._is_collision(new_head) or self.steps > 100*len(self.snake_body):
            game_over = True
            reward = -10  # Collision penalty
        elif new_head == self.food:
            self.score += 1
            reward = 10   # Food reward
            self.food = self._place_food()
        else:
            self.snake_body.pop()  # Remove tail

        return self._get_state(), reward, game_over
Kluczowy okazał się system nagród. Na początku rzadkie nagrody (+10 za jedzenie, -10 za kolizję) sprawiały, że agenci kręcili się w kółko. Dodanie niewielkiej kary za każdy krok zachęciło do szukania jedzenia i zapobiegło nieskończonym pętlom.
Architektura sieci neuronowej musiała być na tyle zaawansowana, żeby nauczyć się złożonych strategii, a jednocześnie dać się wdrożyć na mikrokontrolerze:
def _build_model(self):
    """Neural Network for Deep Q-Learning"""
    model = tf.keras.Sequential([
        tf.keras.Input(shape=(11,)),           # 11-dimensional state
        tf.keras.layers.Dense(24, activation='relu'),  # Hidden layer 1
        tf.keras.layers.Dense(24, activation='relu'),  # Hidden layer 2
        tf.keras.layers.Dense(3, activation='linear')  # 3 actions output
    ])

    model.compile(
        loss='mse',
        optimizer=tf.keras.optimizers.Adam(learning_rate=0.001)
    )
    return model
Dwie warstwy ukryte po 24 neurony dały modelowi wystarczającą moc do inteligentnego zachowania bez przeuczenia. Warstwa wyjściowa oblicza wartości Q dla trzech akcji: prosto, w prawo lub w lewo. Po tysiącach epizodów agent opanował zaawansowane taktyki, takie jak poruszanie się wzdłuż ścian, przeszukiwanie po spirali i unikanie kolizji, zanim do nich dojdzie.
Nordic nRF54L15 i możliwości TinyML
Wybór platformy sprzętowej był kluczowy. Wnioskowanie sieci neuronowej wymagało dużej wydajności, a ograniczenia identyfikatora: niskiego poboru energii i minimalnej ilości pamięci. Wybraliśmy Nordic nRF54L15, mikrokontroler zaprojektowany specjalnie z myślą o erze TinyML.
Dzięki rdzeniowi Arm Cortex-M33 taktowanemu zegarem 128 MHz, 256 KB RAM i 1,5 MB pamięci Flash nRF54L15 zapewnia dobrą równowagę dla embedded AI. Zarządzanie energią pozwala wydajnie prowadzić wnioskowanie, co jest niezbędne w identyfikatorze, który myśli bez przerwy.
Poza samą mocą obliczeniową TinyML wymaga odpowiedniej architektury:
- Wydajne operacje mnożenia z akumulacją (MAC): niezbędne przy mnożeniu macierzy w sieciach neuronowych,
- Tryby uśpienia o niskim poborze energii: oszczędzają baterię w okresach bezczynności,
- Szybki dostęp do pamięci: minimalizuje opóźnienia podczas wnioskowania,
- Wystarczająca ilość RAM: na operacje na tensorach i obliczenia pośrednie.
// TensorFlow Lite Micro configuration
static const int kInputSize  = 11; // 11-dimensional state vector
static const int kOutputSize = 3;  // 3 actions: straight, right, left

static constexpr int kTensorArenaSize = 4 * 1024; // 4KB memory arena
static uint8_t       tensor_arena[kTensorArenaSize];

static tflite::MicroInterpreter* interpreter = nullptr;
static TfLiteTensor* input_tensor  = nullptr;
static TfLiteTensor* output_tensor = nullptr;
Pamięć była dużym ograniczeniem. W przeciwieństwie do AI na komputerach stacjonarnych, gdzie dostępne są gigabajty, systemy embedded muszą z góry zaalokować każdy bajt. Arena tensorów o rozmiarze 4 KB to precyzyjny kompromis między możliwościami modelu a stabilnością systemu.
Inicjalizacja TensorFlow Lite Micro przygotowuje silnik wnioskowania:
// Create a MicroMutableOpResolver for the required operations
static tflite::MicroMutableOpResolver<4> micro_op_resolver;
micro_op_resolver.AddFullyConnected();
micro_op_resolver.AddMul();
micro_op_resolver.AddAdd();
micro_op_resolver.AddRelu();

// Create the interpreter with the pre-allocated memory arena
static tflite::MicroInterpreter static_interpreter(
    model,              // The embedded model data
    micro_op_resolver,  // Operation resolver
    tensor_arena,       // Pre-allocated memory
    kTensorArenaSize    // Arena size (4KB)
);
interpreter = &static_interpreter;

// Allocate memory from the tensor arena
if (interpreter->AllocateTensors() != kTfLiteOk) {
    printk("AllocateTensors() failed");
    return;
}

// Get input and output tensor references
input_tensor  = interpreter->input(0);
output_tensor = interpreter->output(0);
Ta inicjalizacja pokazuje, jak ważne jest w TinyML staranne zarządzanie pamięcią. Każdy bajt jest policzony, a wszystkie alokacje odbywają się przy starcie, żeby uniknąć fragmentacji.
Korzystanie z wytrenowanego modelu
Przejście od treningu w Pythonie do wnioskowania w C++ to kluczowy krok w TinyML. Wytrenowaną sieć trzeba przekonwertować i mocno zoptymalizować, żeby zmieściła się w ścisłych limitach sprzętu mikrokontrolerowego.
Potok konwersji przekształca model Keras do formatu przyjaznego dla systemów embedded:
def convert_to_tflite(model_path='dqn_model.keras', tflite_path='model.tflite'):
    # Load the trained Keras model
    model = tf.keras.models.load_model(model_path)
    converter = tf.lite.TFLiteConverter.from_keras_model(model)
    tflite_model = converter.convert()

    # Save the TFLite model
    with open(tflite_path, 'wb') as f:
        f.write(tflite_model)

    # Generate C header with model weights
    with open('model_data.h', 'w') as f:
        f.write("const unsigned char model_data[] = {")
        f.write(",".join([hex(x) for x in tflite_model]))
        f.write("};\n")
        f.write(f"const unsigned int model_data_len = {len(tflite_model)};\n")

    print(f"Model converted and saved to {tflite_path}")
    print("C header file generated as model_data.h")
Ten potok konwertuje model Keras o precyzji zmiennoprzecinkowej do formatu TensorFlow Lite i generuje plik nagłówkowy C z modelem w postaci tablicy bajtów, którą można wkompilować bezpośrednio w firmware.
Kod wnioskowania w C++ korzysta z tak przekonwertowanego modelu, żeby podejmować decyzje w czasie rzeczywistym:
static int getActionFromModel(void) {
    // Fill input tensor with 11-dimensional state vector
    float* input_data = input_tensor->data.f;
    for (int i = 0; i < kInputSize; i++) {
        input_data[i] = 0.0f;
    }

    // Set direction bits (one-hot encoding)
    switch (snake_dir) {
        case DIR_UP:    input_data[5] = 1.0f; break;
        case DIR_RIGHT: input_data[4] = 1.0f; break;
        case DIR_DOWN:  input_data[6] = 1.0f; break;
        case DIR_LEFT:  input_data[3] = 1.0f; break;
    }

    // Set food direction bits
    int head_x = snake[0].x;
    int head_y = snake[0].y;
    if (food_x < head_x) input_data[7] = 1.0f;  // food_left
    if (food_x > head_x) input_data[8] = 1.0f;  // food_right
    if (food_y < head_y) input_data[9] = 1.0f;  // food_up
    if (food_y > head_y) input_data[10] = 1.0f; // food_down

    // Run neural network inference
    if (interpreter->Invoke() != kTfLiteOk) {
        return 0;  // Default action on inference failure
    }

    // Extract best action using argmax
    float* output_data = output_tensor->data.f;
    int best_idx = 0;
    float best_val = output_data[0];
    for (int i = 1; i < kOutputSize; i++) {
        if (output_data[i] > best_val) {
            best_val = output_data[i];
            best_idx = i;
        }
    }
    return best_idx; // 0=straight, 1=turn right, 2=turn left
}
Ten kod pokazuje cały potok: budowę tego samego 11-wymiarowego wektora stanu co podczas treningu w Pythonie, uruchomienie wnioskowania sieci neuronowej i wybór akcji przez argmax. Wersja embedded odpowiada logice z Pythona, a przy tym mieści się w limicie 4KB pamięci. Kwantyzacja zmniejsza rozmiar modelu o ~75%, zachowując przy tym dobrą jakość gry.
Kreatywna inżynieria spotyka sztukę
Fizyczny projekt pokazuje, jak płytki drukowane mogą stać się dziełami sztuki i zachować przy tym pełną funkcjonalność.
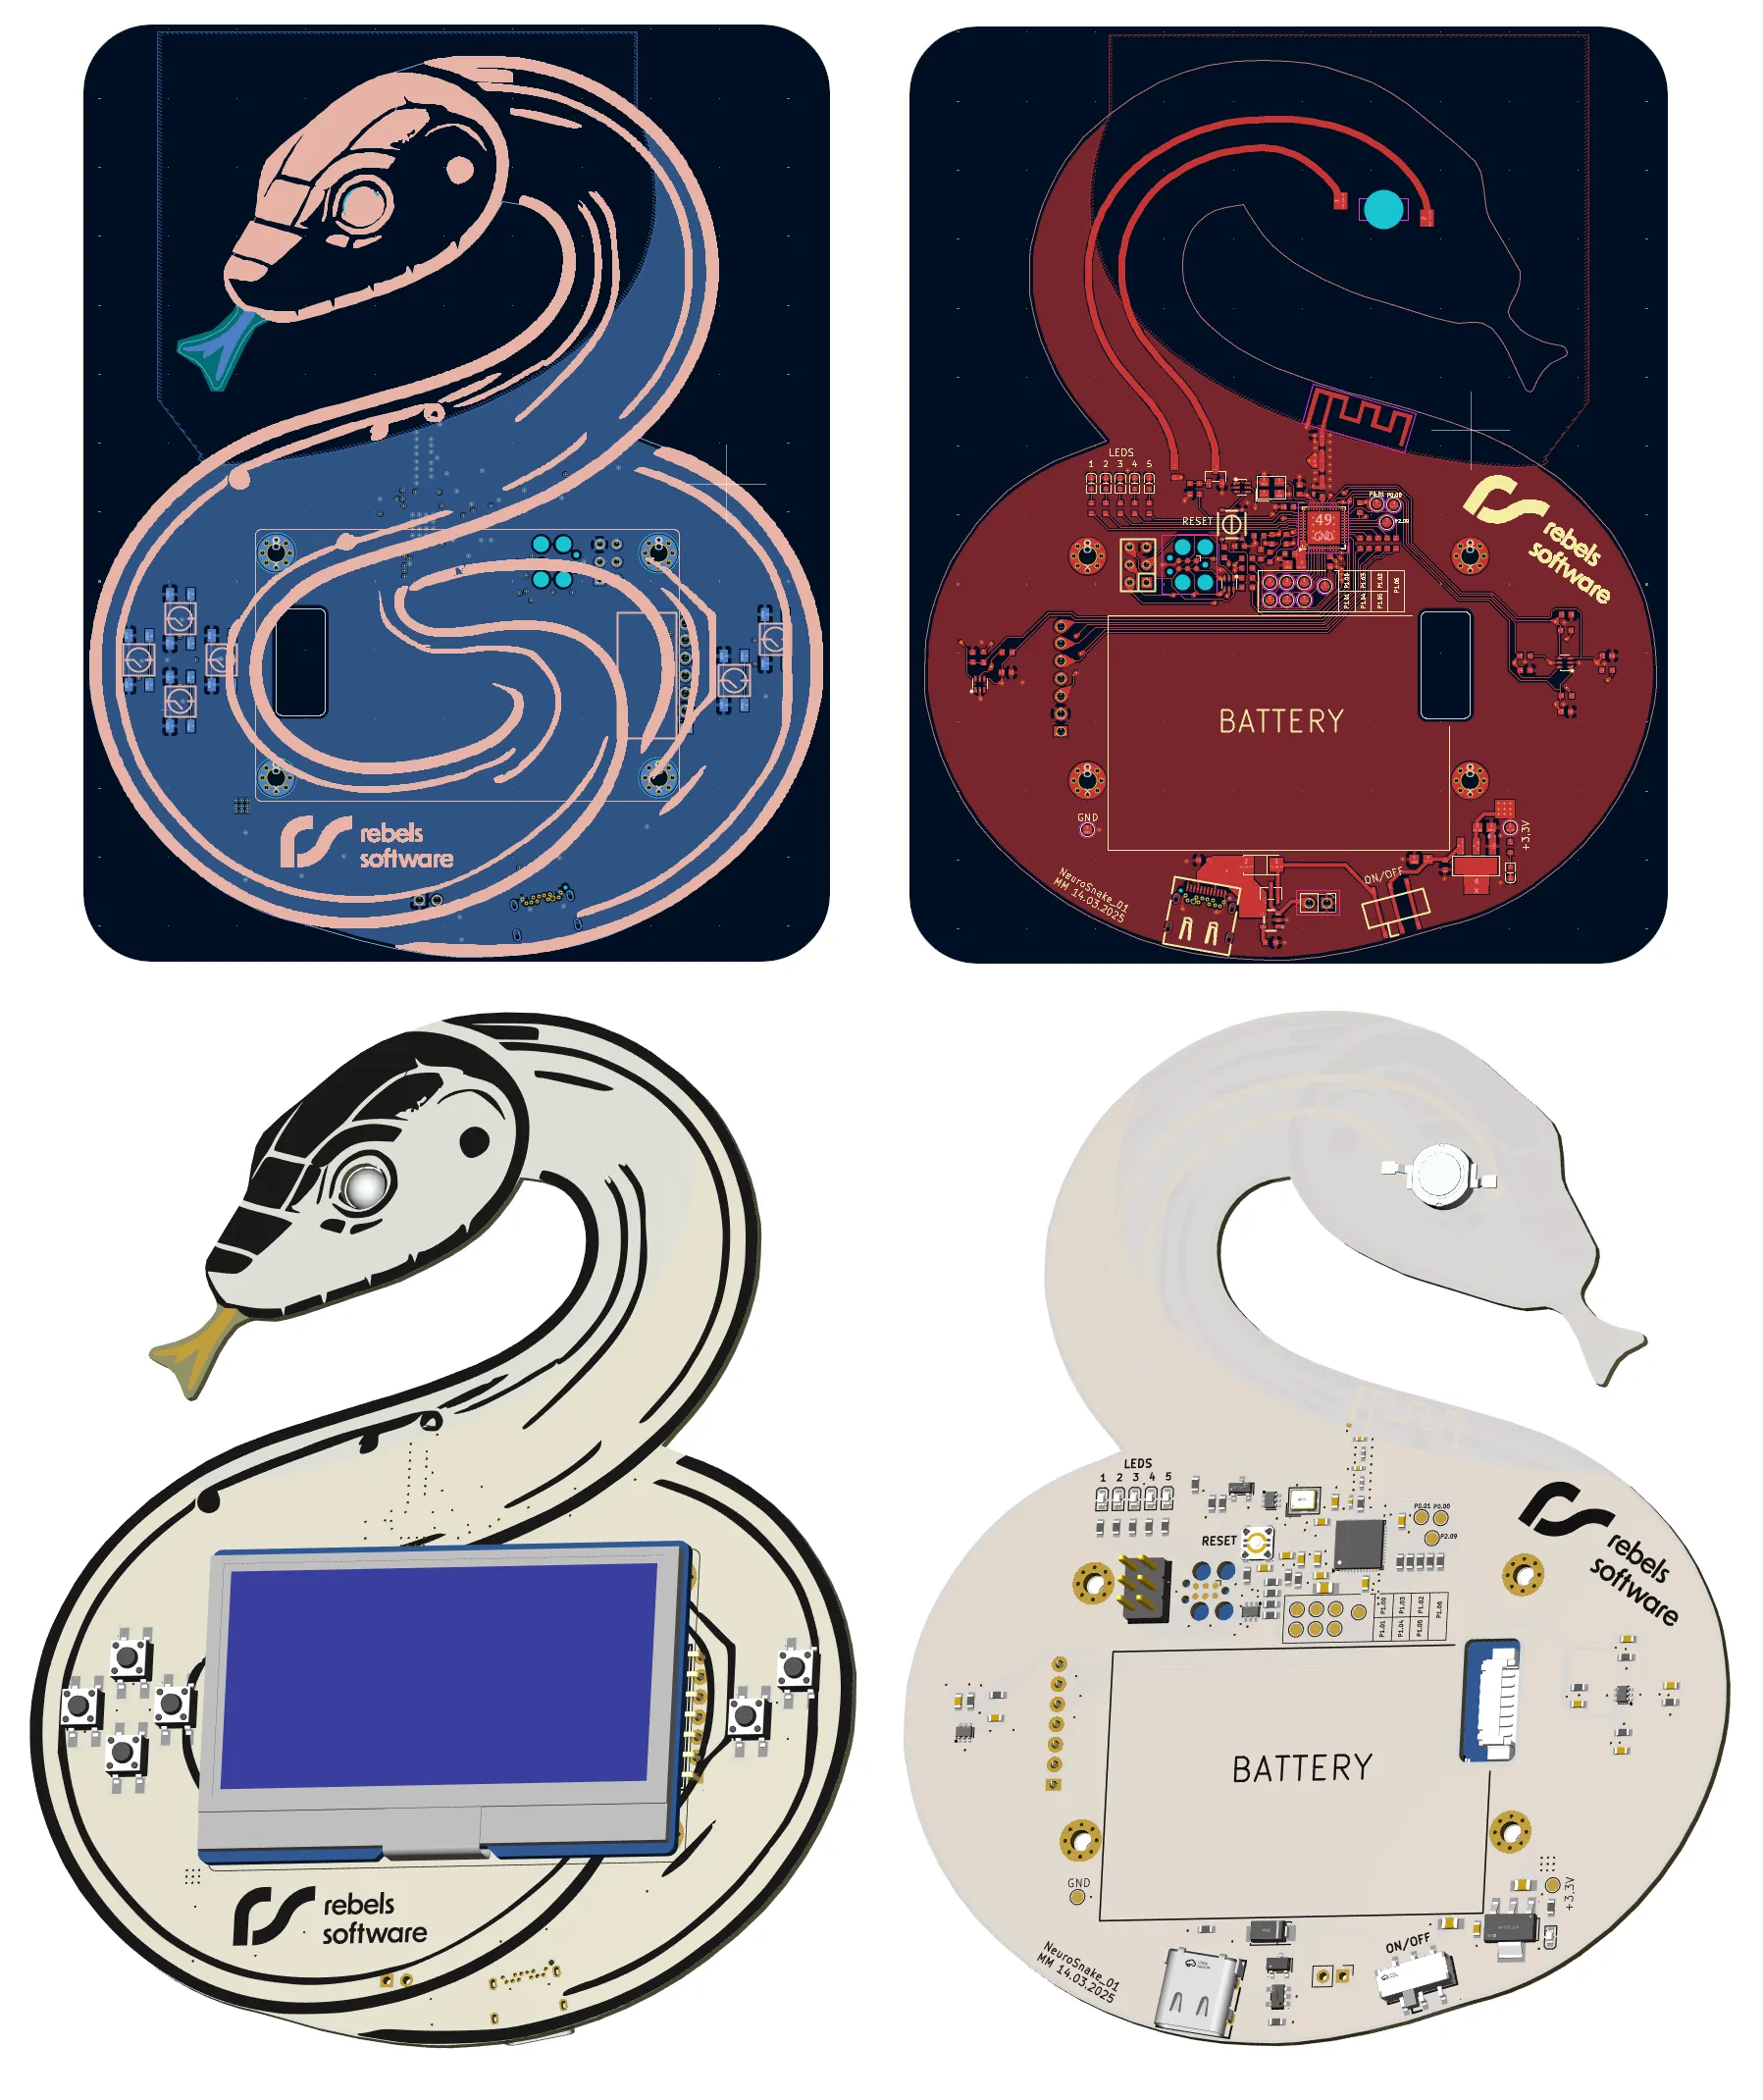
Grafika na PCB pokazuje, że płytka drukowana może być czymś więcej niż czystą funkcją. Układ w kształcie węża wpisuje każdy komponent w płynną, organiczną formę, dzięki której technologia wydaje się żywa i przystępna. Przemyślany projekt płytki drukowanej łączy dbałość o estetykę i funkcjonalność: rozmieszczenie elementów podąża za naturalnymi krzywiznami węża, a połączenia elektryczne pozostają poprawne.
Składamy wszystko w całość
Prace zakończyły się działającą demonstracją TinyML na sprzęcie wielkości identyfikatora, która pokazuje, jak złożone koncepcje AI mogą stać się namacalne i przystępne.
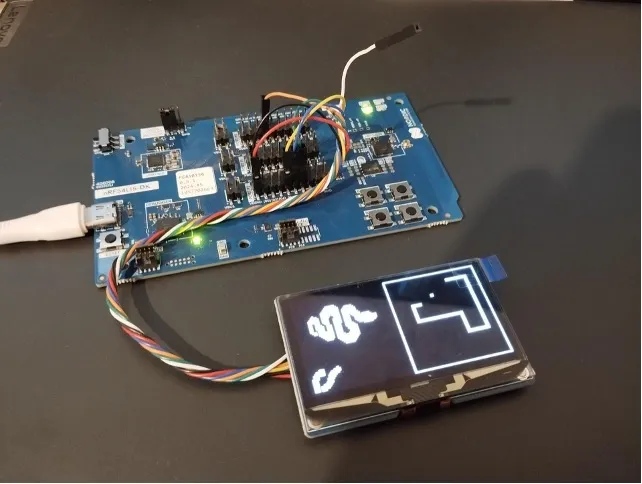
Płytka PCB w kształcie węża i wyświetlacz OLED tworzą wyjątkową, przyciągającą wzrok formę, dzięki której zaawansowane koncepcje AI stają się namacalne i przystępne. Ten identyfikator pokazuje kluczowe możliwości TinyML: wydajne wnioskowanie sieci neuronowej, akcelerację zoptymalizowaną pod kątem zużycia energii i ciągłą pracę na baterii.
Obserwowanie identyfikatora w działaniu potwierdza podstawową prawdę o TinyML: sensowna inteligencja nie wymaga dużej mocy obliczeniowej. Dzięki sprytnej optymalizacji nawet urządzenie wielkości identyfikatora może zapewnić inteligencję maszynową zbliżoną do ludzkiego poziomu. Szczególnie warta uwagi jest efektywność energetyczna: przy średnim poborze zaledwie 45 mA podczas gry urządzenie może działać ponad 8 godzin, co dowodzi, że AI i długi czas pracy na baterii mogą iść w parze.
Nasza perspektywa na koniec
Ten projekt pokazuje coś ekscytującego w TinyML: prawdziwa inteligencja nie potrzebuje chmury ani ciężkiego sprzętu. Dzięki sprytnej optymalizacji i przemyślanemu projektowi nawet urządzenia mieszczące się w dłoni mogą samodzielnie podejmować złożone decyzje. To poprawia prywatność, zmniejsza opóźnienia i oddaje AI bezpośrednio w ręce ludzi.
Snake może i jest prostą grą, ale kiedy na mikrokontrolerze uczy się Cię przechytrzyć, pokazuje znacznie większą zmianę: przyszłość sztucznej inteligencji to nie tylko większa moc, ale też większa efektywność.