Instrukcja7 min czytania
GPT Image 2.6 w aplikacjach firmowych: Sunburst czy Flare
Chcesz generować obrazy w aplikacji firmowej, a OpenAI oferuje teraz dwa modele GPT Image 2.6 w tej samej cenie, ale o innych mocnych stronach. Sunburst służy do pracy wymagającej detalu i precyzyjnej edycji, Flare do szybkich iteracji. Oba działają przez Image API i wprowadzają parametr complexity, edycję sterowaną znacznikami oraz wynik w SVG i GIF. Gdy liczy się czas odpowiedzi, zacznij od Flare, a gdy każdy szczegół musi się zgadzać, od Sunburst. Potem sprawdź oba na własnych promptach.
Co nowego w GPT Image 2.6
OpenAI udostępniło Sunburst i Flare 4 listopada 2026 r. jako gpt-image-2.6-sunburst i gpt-image-2.6-flare. Przewodnik po generowaniu obrazów wymienia trzy nowości:
complexity(low,medium,high) określa, ile model planuje przed renderowaniem. Domyślna wartość tohigh, bez dodatkowej opłaty. Wyższy poziom pomaga przy gęstym tekście i złożonym układzie, ale może wydłużyć odpowiedź i wprowadzić zmiany, o które nie prosisz.- Edycja sterowana znacznikami: przy edycji wysyłasz jako
markupprzezroczysty PNG z kółkami albo szkicem. Musi mieć rozmiar pierwszego obrazu wejściowego. - Wynik w SVG i jako animowany GIF, tylko na endpoincie generowania.
Sunburst, Flare, GPT Image 2 i 2.5 w porównaniu
| 2.6 Sunburst | 2.6 Flare | 2.5 Sunburst / Flare | GPT Image 2 | |
|---|---|---|---|---|
| Przeznaczenie | Detal, precyzyjna edycja | Szybkie iteracje | Sunburst: precyzja edycji. Flare: szybkie codzienne generowanie | Szybkie generowanie i edycja w wysokiej jakości |
| API | Tylko Image API | Tylko Image API | Image API i narzędzie obrazów w Responses API | Image API |
| Batch | Brak | Brak | Jest (strona Sunburst) | Jest |
quality |
od auto do max |
od auto do max |
od auto do max |
low, medium, high, auto |
complexity |
Tak | Tak | Brak w dokumentacji | Odrzucone z błędem 400 w naszym teście |
Źródła: strony modeli Sunburst, Flare, 2.5 Sunburst i GPT Image 2 oraz przewodnik po promptach.
Obie strony modeli 2.6 podają te same stawki: 5 USD za 1M tokenów tekstu na wejściu, 8 USD za 1M tokenów obrazu na wejściu i 30 USD za 1M tokenów obrazu na wyjściu. Oficjalnej ceny za obraz nie ma, więc licz koszt zaakceptowanego obrazu na własnych danych. Przy dużych partiach to ważne, bo 2.6 nie obsługuje Batch: strona 2.5 Sunburst podaje dla Batch 15 USD za 1M tokenów obrazu na wyjściu, wobec 30 USD w trybie standardowym.
Krok po kroku: GPT Image 2.6 w Twojej aplikacji
- Wybierz jedno zadanie. Zdjęcia produktów na przezroczystym tle, warianty marketingowe, schematy do dokumentacji, tłumaczone infografiki albo podglądy interfejsu. Przewodnik po promptach ma przykłady dla większości z nich.
- Wybierz model na start. Przewodnik po promptach zaleca Flare, gdy najważniejszy jest czas odpowiedzi, a Sunburst przy wysokich wymaganiach co do detalu, układu albo dokładności edycji. Jeśli GPT Image 2 daje Ci już akceptowalną jakość albo używasz 2.5 Flare, zacznij od 2.6 Flare. Jeśli używasz 2.5 Sunburst, zacznij od 2.6 Sunburst.
- Ustaw parametry.
quality:auto,low,medium,high,xhigh,max.size:auto,1024x1024,1536x1024,1024x1536albo własny rozmiar w wielokrotnościach 16, w proporcjach od 1:3 do 3:1.background: transparentwymaga PNG albo WebP.output_format:png,jpeg,webp, a przy generowaniu takżesvgigif. Przy edycji pomińinput_fidelity. - Wygeneruj obraz.
OpenAI()pobiera klucz ze zmiennejOPENAI_API_KEY, więc nie trafia on do kodu. Odpowiedź zawiera obiektusagez tokenami tekstu i obrazu na wejściu oraz tokenami wyjściowymi.
import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY from the environment

result = client.images.generate(
    model="gpt-image-2.6-flare",
    prompt="A clean product photo of a steel thermos on a white table, soft daylight, no text, no logos.",
    size="1536x1024",
    quality="medium",
    output_format="jpeg",
    complexity="medium",  # 2.6 models only, gpt-image-2 rejects it
)
Path("thermos.jpg").write_bytes(base64.b64decode(result.data[0].b64_json))
print(result.usage)- Edytuj na podstawie zdjęć referencyjnych. Przekaż do
images.editlistę zdjęć referencyjnych i napisz, co ma się zmienić, a co zostać. W naszych testach dwa zdjęcia referencyjne lepiej oddawały podobieństwo niż jedno. Jeśli na obrazie ma być polski tekst, sprawdź znaki takie jak „ą”, „ł” czy „ż”.
LIKENESS = (
    "Use both reference photos of the same person as identity guides only. "
    "Preserve the person's likeness. Do NOT copy the expression or head angle "
    "from the references, invent a new expression and pose as described. "
    "Photorealistic."
)
PROMPT = (
    f"{LIKENESS} The person is a mountain guide on a rocky trail near a summit with "
    "a small flag, green valleys below, laughing, head turned three-quarters to "
    "camera, giving a client a high five. Fun, casual, confident mood. "
    "No text, no words, no logos."
)

with open("reference.jpg", "rb") as ref1, open("reference2.jpg", "rb") as ref2:
    result = client.images.edit(
        model="gpt-image-2.6-sunburst",
        image=[ref1, ref2],
        prompt=PROMPT,
        size="1024x1024",
        quality="medium",
        output_format="jpeg",
        complexity="medium",
    )
Path("mountain-sunburst.jpg").write_bytes(base64.b64decode(result.data[0].b64_json))- Porównaj modele na własnym materiale. Ten sam prompt, te same zdjęcia referencyjne, stałe
size,qualityi format pliku.complexitytrafia tylko do modeli 2.6, bo GPT Image 2 go odrzuca.
import time

MODELS = ["gpt-image-2.6-sunburst", "gpt-image-2.6-flare", "gpt-image-2"]

for model in MODELS:
    params = dict(model=model, prompt=PROMPT, size="1024x1024", quality="medium", output_format="jpeg")
    if model != "gpt-image-2":
        params["complexity"] = "medium"  # gpt-image-2 rejects this field with a 400 error

    start = time.perf_counter()
    with open("reference.jpg", "rb") as ref1, open("reference2.jpg", "rb") as ref2:
        result = client.images.edit(image=[ref1, ref2], **params)
    elapsed = time.perf_counter() - start
    Path(f"mountain-{model}.jpg").write_bytes(base64.b64decode(result.data[0].b64_json))

    usage = result.usage
    text_in = usage.input_tokens_details.text_tokens
    image_in = usage.input_tokens_details.image_tokens
    # USD per 1M tokens: text in $5, image in $8, image out $30
    cost = (text_in * 5 + image_in * 8 + usage.output_tokens * 30) / 1_000_000
    print(f"{model}: {elapsed:.1f} s, tokens {text_in}/{image_in}/{usage.output_tokens}, ${cost:.4f}")
Wyniki jednego testu
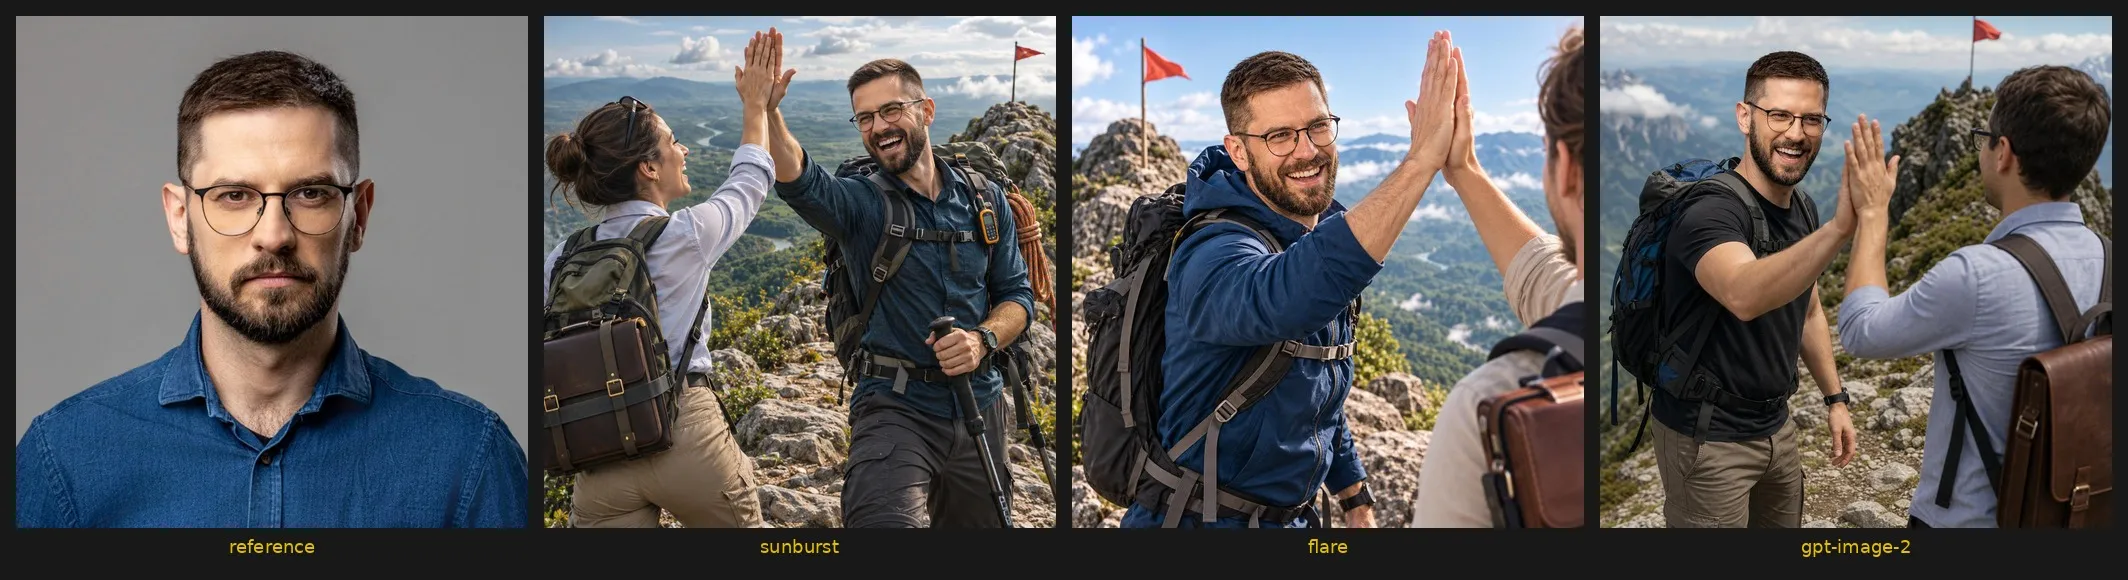
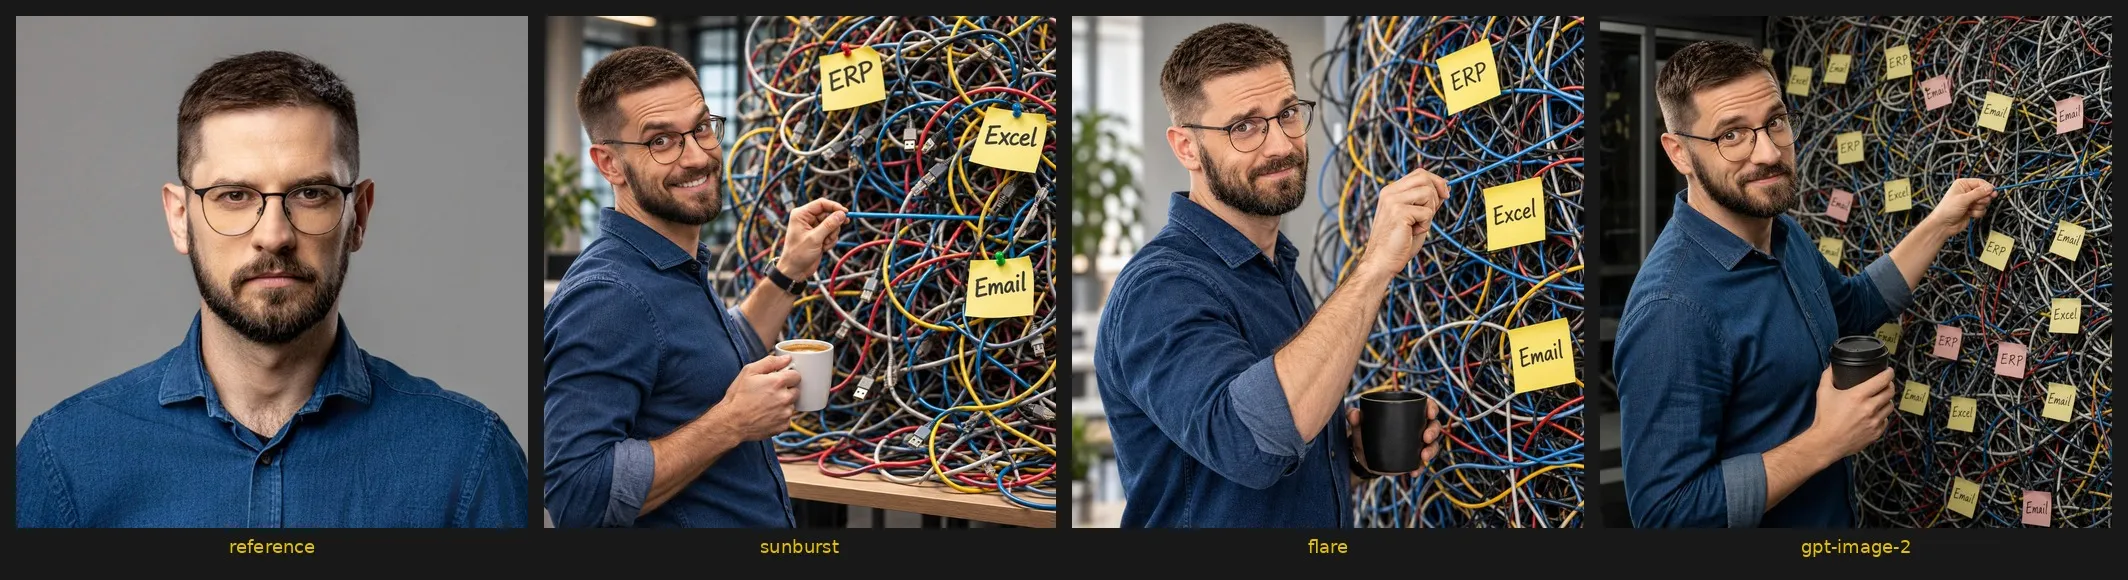
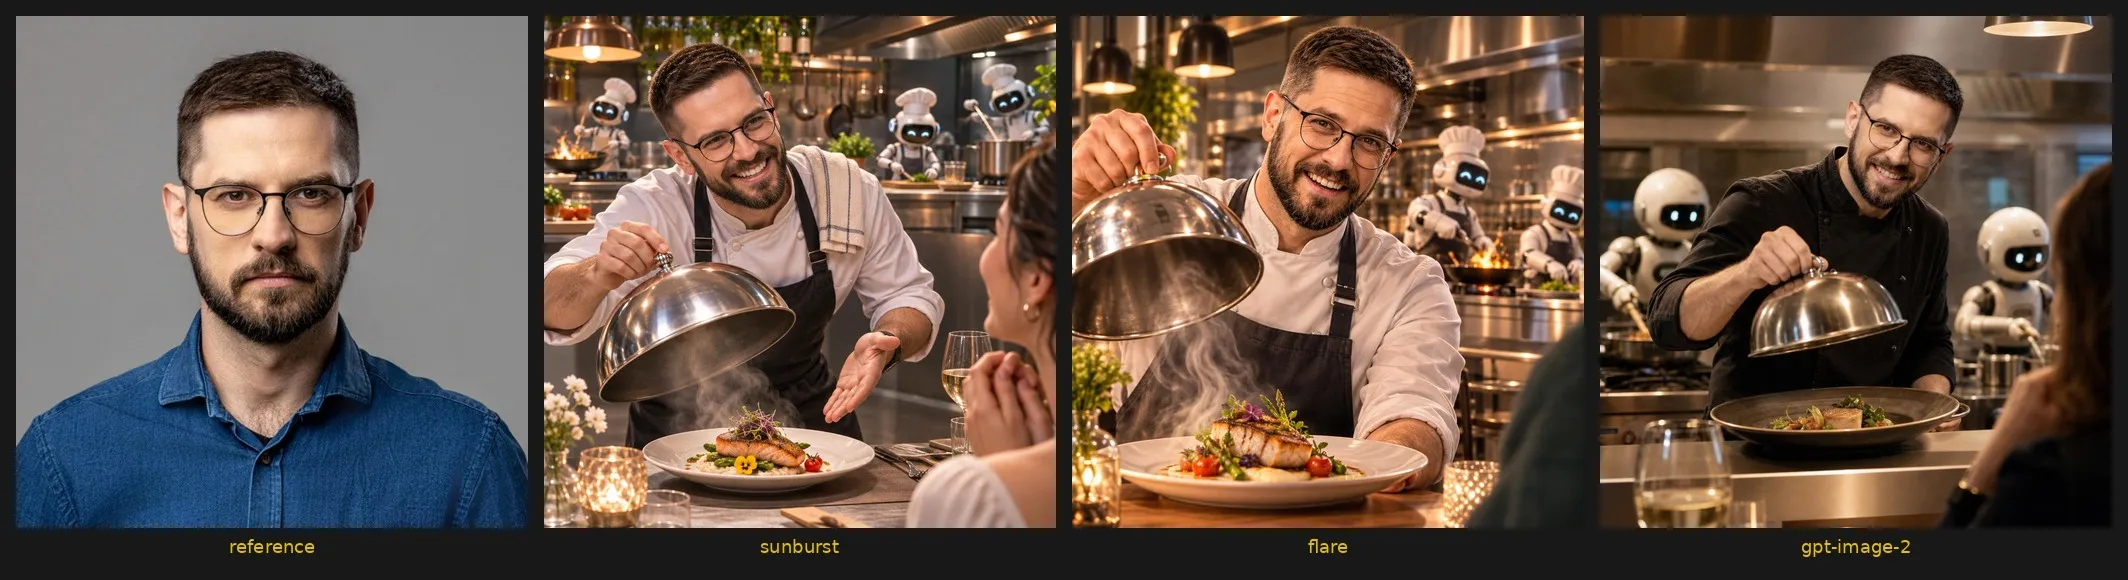
Trzy sceny (przewodnik górski, ktoś rozplątujący kable i karteczki, szef kuchni podający danie), dwa zdjęcia referencyjne, jeden przebieg na model i scenę, 1024x1024, jakość medium, complexity="medium" tylko w 2.6. Czasy dotyczą wyłącznie udanego wywołania. Koszt to zużycie tokenów razy opublikowane stawki; dla GPT Image 2 jest szacunkowy, według tych samych stawek, bo strona modelu nie podaje ceny.
| Model | Góry | Chaos | Kuchnia | Koszt z tokenów |
|---|---|---|---|---|
gpt-image-2.6-sunburst |
22,9 s | 25,3 s | 22,3 s | 0,0646-0,0647 USD |
gpt-image-2.6-flare |
11,2 s | 15,1 s | 9,6 s | 0,0646-0,0647 USD |
gpt-image-2 |
41,7 s | 40,9 s | 38,8 s | 0,0737-0,0738 USD (szacunkowo) |
Tokeny na wywołanie: około 160-172 tokenów tekstu na wejściu w 2.6 i 140-152 w GPT Image 2, 2545 tokenów obrazu na wejściu we wszystkich, a na wyjściu 1449 w 2.6 wobec 1756 w GPT Image 2.
- Wdrażaj po jednym procesie. OpenAI radzi najpierw przenieść niewielką część ruchu. Zanim przeniesiesz resztę, obserwuj czas odpowiedzi, błędy, ponowienia i koszt zaakceptowanego obrazu.
Najczęstsze błędy
- Duża partia zaplanowana na Batch. Wersja 2.6 go nie obsługuje, więc najpierw porównaj koszt z 2.5 albo GPT Image 2.
- Wywoływanie 2.6 przez Responses API. Ta droga nie jest obsługiwana. Używaj
v1/images/generationsiv1/images/edits. - Wysyłanie do GPT Image 2 żądań przygotowanych dla 2.6. Jego skala jakości kończy się na
high, a parametrcomplexityjest odrzucany. - Brak kontroli tekstu. OpenAI wymienia rozmieszczenie tekstu wśród znanych ograniczeń, obok czasu generowania do 2 minut przy złożonych promptach. Przeczytaj każdy napis, zanim obraz trafi do użytkowników.
- Zdjęcia, których nie wolno Ci przetwarzać. Zdjęcia osób i dokumenty klientów to dane osobowe albo poufne. Jeśli muszą zostać w Twojej sieci, zajrzyj do poradnika jak przygotować dokumenty firmy pod prywatne AI.
Wnioski
- Flare, gdy liczy się czas. W każdej scenie mniej więcej dwa razy szybszy od Sunburst, przy dokładnie tym samym koszcie. Sprawdza się przy okładkach, wariantach i szybkich iteracjach w aplikacji.
- Sunburst do ludzi i precyzyjnych edycji. Najlepiej trzymał podobieństwo i szczegóły. Gdy twarz albo produkt muszą wyglądać dobrze, dodatkowe 10-13 sekund się opłaca.
- Niewiele powodów, żeby zostać przy GPT Image 2. Był najwolniejszy, przy tych samych stawkach około 14% droższy i nie ma
complexity. Wyjątkiem są duże partie oparte na Batch, którego 2.6 nie obsługuje. - Szkic we Flare, wersja końcowa w Sunburst. Szybko iterujesz, a dłużej czekasz tylko na wersję, która trafi do użytkowników.
- Proś o podobieństwo, nie o identyczną twarz. We wcześniejszych próbach prompty żądające „identycznej twarzy” zamrażały minę. Znacznie lepiej działało proszenie wyłącznie o podobieństwo, opisanie nowej emocji i ustawienia głowy w każdej scenie oraz dodanie drugiego zdjęcia referencyjnego.
Jeden przebieg na model i scenę to nie benchmark. Zanim podejmiesz decyzję, powtórz porównanie na własnym materiale.
Następny krok
Wybierz jedno zadanie graficzne w swojej aplikacji, zbierz 10-20 prawdziwych przykładów i przepuść je przez pętlę porównawczą z Sunburst i Flare. Zostaw model, który spełnia Twój próg jakości przy akceptowalnym dla Ciebie czasie odpowiedzi i koszcie zaakceptowanego obrazu.
Jeśli chcesz, żeby to działało w gotowej aplikacji, porozmawiaj z Rebels Software. Tworzymy aplikacje na zamówienie, prywatne AI i agentów AI, a generowanie obrazów jest często jednym krokiem w dłuższym procesie, o czym piszemy w poradniku jak wybrać pierwszy proces dla agenta AI. Zaczynamy od warsztatu Discovery, sprawdzamy jeden przypadek jako PoC na Twoich danych, wdrażamy go i utrzymujemy w ramach Rebels Care. Umów rozmowę na tej stronie.